O que é LLM: como a IA do ChatGPT e do Claude funciona
Entenda o que é LLM, como esses modelos de linguagem aprendem e respondem, por que erram e como usar essa noção para pedir melhor à IA.
Neste artigo (9 seções)
- O que é LLM, em uma frase
- Como um LLM funciona, passo a passo
- Janela de contexto: a memória de trabalho do LLM
- Por que o LLM erra: a alucinação
- LLM não é só ChatGPT: os modelos que você já usa
- O que um LLM faz bem e o que faz mal
- Como usar o que você aprendeu para pedir melhor
- LLM e agentes: o próximo passo
- Seu próximo passo
Você usa o ChatGPT, o Claude ou o Gemini e, de vez em quando, ouve alguém falar em “LLM”. Se você quer saber o que é LLM sem entrar em matemática, a resposta curta é esta: é o modelo de IA treinado com enormes quantidades de texto que faz esses assistentes conversarem, resumirem e escreverem. Neste guia você vai entender como ele funciona, por que às vezes erra com tanta confiança e o que fazer com isso no dia a dia.
O que é LLM, em uma frase
LLM é a sigla de Large Language Model, em português, grande modelo de linguagem. É um programa treinado com livros, artigos, páginas da web e código para reconhecer padrões da linguagem humana. Com esses padrões, ele consegue continuar um texto, responder perguntas, traduzir, resumir e escrever código.
O “grande” vem do tamanho. Esses modelos têm bilhões de parâmetros, que são os números internos ajustados durante o treinamento, como se fossem milhões de pequenos botões de regulagem. Segundo a Fast Company Brasil, os maiores podem chegar a trilhões deles.
Um jeito simples de pensar: o LLM é o motor, e o ChatGPT, o Claude e o Gemini são os carros. O motor é o modelo. O carro é o aplicativo que você abre, com tela de conversa, histórico, planos e limites. Quando a OpenAI lança o GPT-6, por exemplo, ela lança um novo modelo que passa a rodar dentro do ChatGPT. Foi o caso do GPT-6 no ChatGPT.
Como um LLM funciona, passo a passo
Por dentro, a ideia central é menos misteriosa do que parece. O modelo faz uma única coisa, várias vezes seguidas: prever qual é o próximo pedaço de texto mais provável.
- Seu texto é cortado em tokens. Token é um pedaço de texto: pode ser uma palavra curta, parte de uma palavra longa ou um sinal de pontuação. É nessa unidade que o modelo “lê” e que os planos cobram e limitam o uso.
- O modelo avalia o contexto. Usando uma arquitetura chamada transformer, apresentada em 2017, ele pesa a relação entre os tokens, mesmo os que estão longe um do outro. É isso que permite entender que o “ela” no fim do parágrafo se refere à pessoa citada no começo.
- Ele calcula a continuação mais provável. Cada token candidato recebe uma probabilidade, e um deles é escolhido.
- O ciclo se repete. O token escolhido entra no contexto e o modelo prevê o seguinte, até formar a resposta inteira.
Por isso a resposta aparece “digitando” na tela: ela é gerada pedaço por pedaço. Não existe uma resposta pronta guardada em algum lugar. Ela é construída na hora.
Como o modelo aprende
O treinamento tem etapas. Primeiro vem a coleta e a limpeza de um volume enorme de texto. Depois, o aprendizado autossupervisionado: o modelo tenta prever o que vem a seguir, compara com o texto real e ajusta seus parâmetros, num ciclo repetido bilhões de vezes.
Em seguida, os desenvolvedores costumam refinar o modelo com ajustes finos e com feedback humano, para que ele siga instruções, responda com educação e recuse pedidos perigosos. É por isso que um assistente de conversa se comporta diferente de um modelo “cru”, que apenas completaria o texto.
Janela de contexto: a memória de trabalho do LLM
Um conceito que aparece toda hora nos planos e nas notícias é a janela de contexto. Segundo a documentação da Anthropic, ela é todo o texto que o modelo consegue consultar ao gerar uma resposta, incluindo a própria resposta. A empresa a compara a uma “memória de trabalho”, diferente da base enorme de dados usada no treinamento.
Tudo conta nessa janela: as instruções do sistema, o histórico da conversa, os arquivos que você anexou e o texto que o modelo está escrevendo. Em outubro de 2026, a documentação da Anthropic informa que modelos como o Claude Opus 5.5, o Sonnet 5.5 e o Haiku 5.5 têm janela de 1 milhão de tokens.
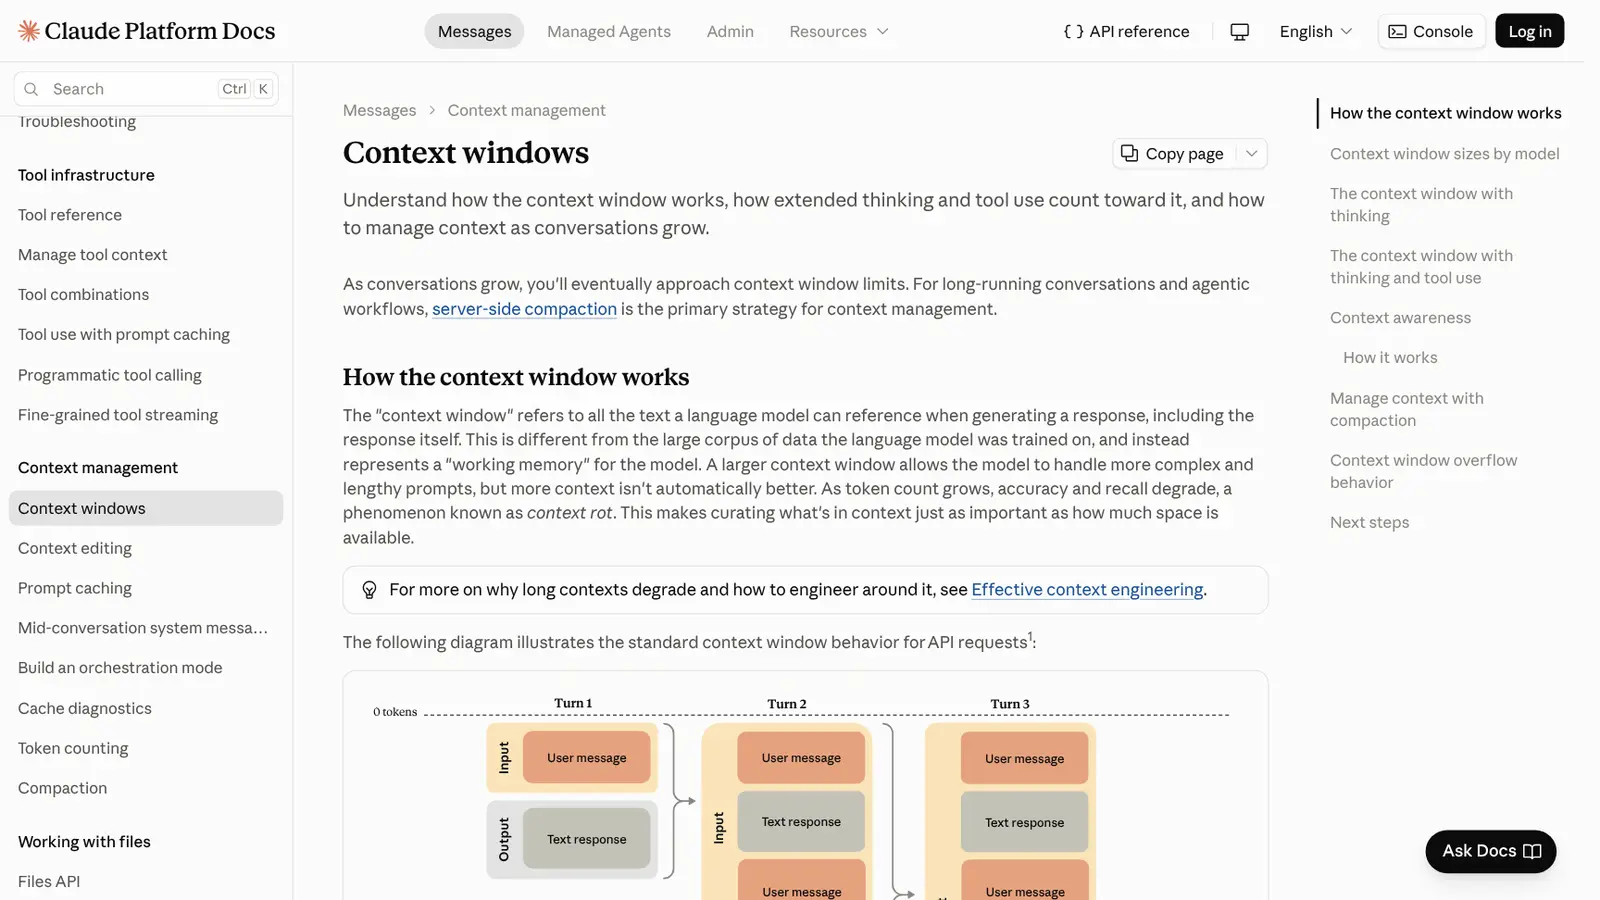
Janela grande não significa que o modelo lembra de tudo com a mesma qualidade. A própria Anthropic avisa que mais contexto não é automaticamente melhor: à medida que o número de tokens cresce, a precisão e a lembrança podem piorar, um efeito que ela chama de context rot. Na prática, isso muda a forma de usar:
- Conversas muito longas pedem um recomeço de vez em quando, com um resumo do que importa.
- Anexar só os trechos relevantes costuma funcionar melhor do que jogar 300 páginas de uma vez.
- Quanto mais tokens você gasta, mais rápido o limite do seu plano acaba. Veja como isso funciona no guia sobre o limite de uso do Claude.
Por que o LLM erra: a alucinação
Como o modelo gera texto por probabilidade, ele pode produzir algo que soa perfeito e está errado. Esse fenômeno é chamado de alucinação. Veja o guia completo sobre o que é alucinação de IA. Pode ser uma lei que não existe, uma citação inventada, um preço desatualizado ou um número fora do lugar.
Alguns pontos ajudam a entender o risco:
- O modelo não consulta uma base de fatos por padrão. Ele depende dos padrões do treinamento. Se a ferramenta tem busca na web ou acesso aos seus arquivos, a resposta melhora, mas ainda precisa de conferência.
- Tom confiante não é sinal de acerto. A resposta errada costuma vir tão bem escrita quanto a certa.
- Vieses também entram. Se os textos de treinamento têm distorções, o modelo pode reproduzi-las.
Atenção
Nunca use uma resposta de LLM, sem conferir, em decisão sobre saúde, dinheiro, contrato ou prazo. Peça a fonte, abra o link e confirme no site oficial.
LLM não é só ChatGPT: os modelos que você já usa
Cada empresa treina a sua família de modelos. Em outubro de 2026, os exemplos mais conhecidos são:
| Empresa | Produto de conversa | Exemplos de modelos |
|---|---|---|
| OpenAI | ChatGPT | GPT-6 Sol e GPT-6 Luna |
| Anthropic | Claude | Opus 5.5, Sonnet 5.5, Haiku 5.5 |
| Gemini | Gemini 3.1 Pro, Gemini 3.5 Flash-Lite |
Repare que quase toda família tem modelos de tamanhos diferentes. Os maiores raciocinam melhor e custam mais. Os menores respondem rápido e gastam menos do seu limite. Escolher o modelo certo para cada tarefa é uma das formas mais simples de render mais.
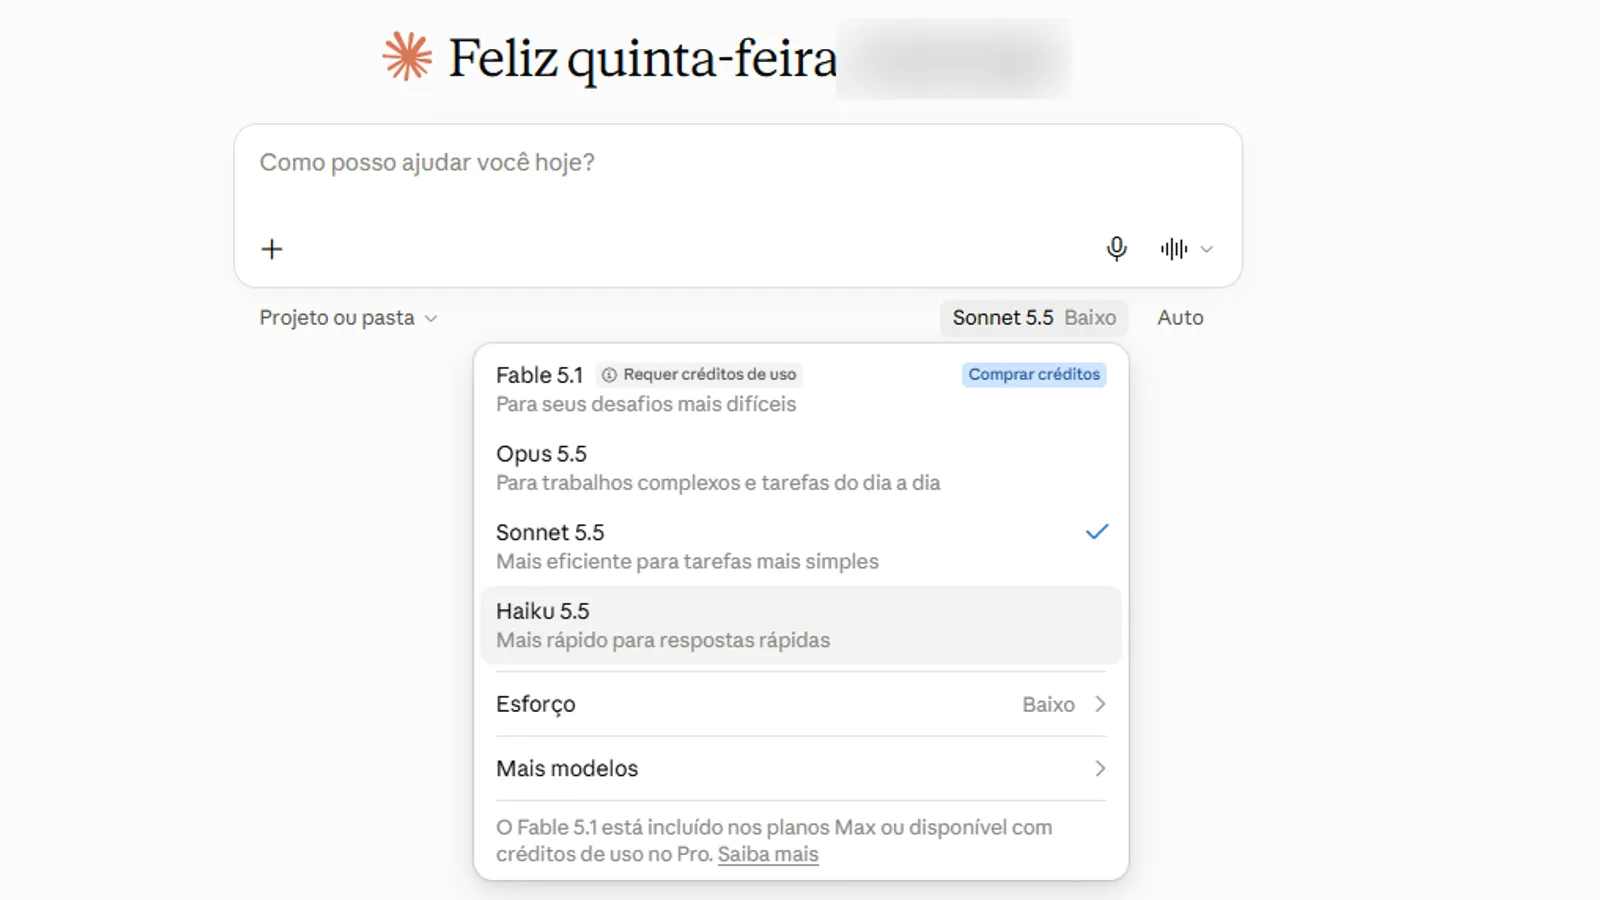 O guia sobre qual modelo do Claude usar mostra um exemplo prático dessa escolha.
Outra distinção útil: LLM é só uma parte da IA generativa. Modelos que criam imagem, voz ou vídeo usam outras técnicas, embora muitos produtos juntem várias delas num só aplicativo.
O que um LLM faz bem e o que faz mal
Entender o mecanismo ajuda a saber onde confiar.
Faz bem:
- Reescrever, resumir e traduzir textos que você fornece.
- Organizar ideias, montar roteiros, tabelas e listas.
- Explicar um assunto de vários jeitos, no seu ritmo.
- Gerar e revisar código e fórmulas de planilha.
Faz mal, ou exige conferência:
- Dados recentes, preços, datas e números exatos, se o modelo não tiver busca ativa.
- Contas longas e raciocínio com muitas etapas, sem revisão.
- Fatos sobre pessoas e empresas pequenas, que aparecem pouco nos textos de treinamento.
- Qualquer coisa que dependa de informação sua que você não passou.
Como usar o que você aprendeu para pedir melhor
Saber que o modelo prevê a continuação do contexto muda a forma de escrever o pedido. Quanto mais claro o contexto, mais certeira a resposta.
Exemplo de antes e depois
Antes: “Escreve um e-mail para o cliente.”
Depois: veja o prompt abaixo.
Você é assistente de uma loja de materiais de construção em Campinas. Escreva um e-mail curto e educado para um cliente cuja entrega atrasou 2 dias. Peça desculpas sem exagero, ofereça 10% de desconto na próxima compra e informe que a nova data de entrega é sexta-feira. Use tom cordial e termine com o telefone (19) 0000-0000 para contato.No segundo pedido, o modelo recebeu quem fala, para quem, o problema, a solução e o tom. Sobra pouco espaço para chute. Para montar pedidos assim sem esforço, use o gerador de prompts, e para se aprofundar, leia como fazer um bom prompt.
Prompts prontos para testar o seu LLM
Use estes pedidos para sentir os pontos fortes e os limites do modelo:
Explique o que é um token como se eu tivesse 12 anos. Depois, mostre como a frase "Vou pagar no Pix amanhã" poderia ser dividida em tokens.Resuma o texto abaixo em 5 tópicos. Se alguma informação não estiver no texto, escreva "não consta no texto" em vez de completar por conta própria.
[cole o texto aqui]Responda à pergunta abaixo e diga qual é o seu nível de certeza de 0 a 10. Se tiver menos de 8, liste o que eu preciso conferir em fontes oficiais.
[sua pergunta]O segundo e o terceiro prompts reduzem as alucinações porque dão ao modelo uma saída honesta. Sem ela, ele tende a completar.
Dica
Peça ao modelo para dizer o que não sabe. Frases como “se não houver dado no texto, avise” cortam boa parte das respostas inventadas.
LLM e agentes: o próximo passo
Um LLM sozinho só gera texto. Quando ele ganha acesso a ferramentas, como agenda, e-mail, planilhas ou o navegador, passa a executar tarefas. É aí que entram os conectores e o protocolo que os padroniza, explicado em o que é MCP. O modelo continua o mesmo; o que muda é o que ele consegue tocar.
Seu próximo passo
Abra o assistente que você já usa e faça o teste dos três prompts acima com um texto seu. Anote onde o modelo acertou, onde ficou genérico e onde inventou. Em dez minutos você terá uma noção prática dos limites do seu LLM, melhor do que qualquer definição. Depois, escolha uma tarefa repetitiva da sua semana, como responder clientes ou resumir reuniões, e monte um prompt modelo para ela.
Lembre que os modelos e planos mudam rápido. Os nomes e números citados aqui refletem outubro de 2026. Antes de decidir qualquer compra, confira as páginas oficiais.
Perguntas frequentes
O que significa LLM?
LLM vem de Large Language Model, em português, grande modelo de linguagem. É o tipo de IA treinada com muito texto que está por trás de ChatGPT, Claude e Gemini.
LLM e ChatGPT são a mesma coisa?
Não. O LLM é o modelo, o motor. O ChatGPT é o produto, o aplicativo de conversa que usa modelos da OpenAI, como o GPT-6. O mesmo vale para o Claude e o Gemini.
Um LLM entende o que eu escrevo?
Ele reconhece padrões de linguagem e calcula a continuação mais provável. O resultado parece compreensão e costuma ser útil, mas o modelo não verifica fatos por conta própria.
Por que o LLM inventa informações?
Porque ele gera texto por probabilidade. Quando falta informação, ele pode completar com algo que soa plausível e está errado. Esse erro é chamado de alucinação.
Preciso pagar para usar um LLM?
Não necessariamente. ChatGPT, Claude e Gemini têm planos grátis, com limites. Os planos pagos liberam mais uso e modelos maiores.